Постоянный признак можно удалить из учебного набора: если его значение одинаково у всех объектов, по нему нельзя различить строки. Этот вывод относится к проверенным данным — в будущих данных значения признака могут отличаться.
Признак — характеристика объекта, представленная столбцом таблицы. Чтобы найти постоянный признак, сравните значения внутри каждого столбца.
Как найти постоянный признак в таблице
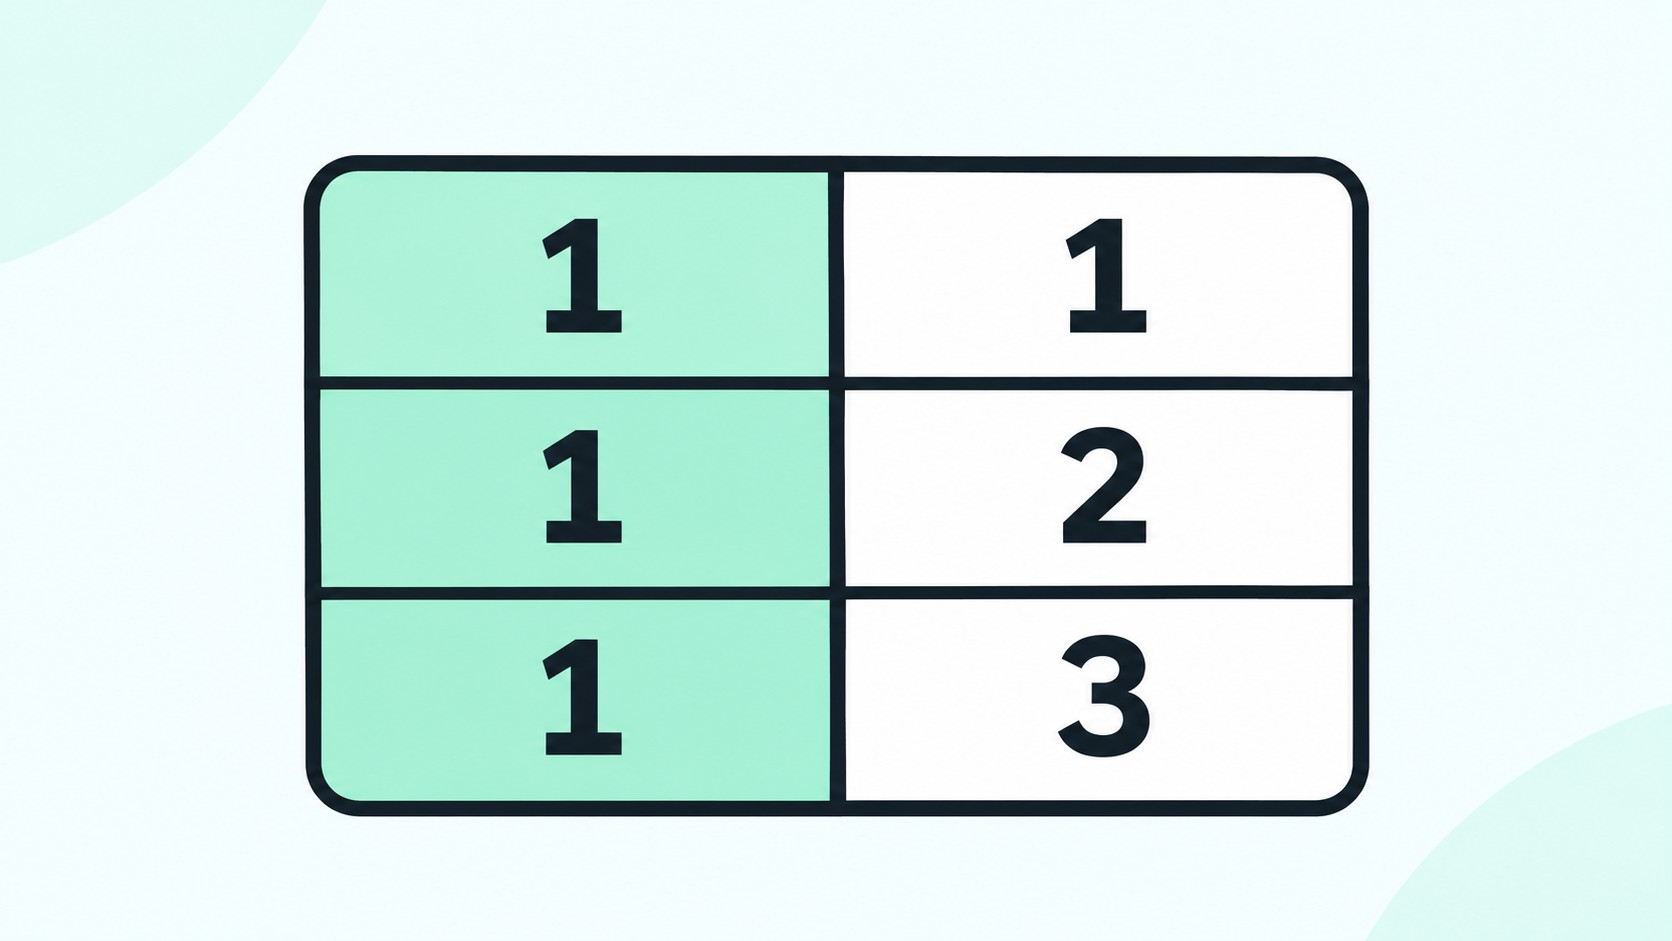
Возьмём условную учебную таблицу без пропусков. В ней три объекта и два числовых признака:
| Объект | Признак A | Признак B |
|---|---|---|
| Первый | 1 | 1 |
| Второй | 1 | 2 |
| Третий | 1 | 3 |
Сравним значения по столбцам:
- Признак A равен 1 у каждого объекта. Он постоянный: зная только значение A, нельзя определить, к какой строке оно относится.
- Признак B меняется от строки к строке. Его значения позволяют различить объекты в этой таблице.
Если удалить A, останется B. Мы убрали столбец, который не добавлял различий между строками выбранного набора. При этом мы не доказали, что A будет постоянным в других данных, и не оценили связь B с тем, что хотим предсказать.
Что показывает дисперсия
Дисперсия — мера разброса значений признака. Если все значения одинаковы, разброса нет и дисперсия равна нулю.
В нашей таблице у признака A нулевая дисперсия: все его значения равны 1. Значения B различаются, поэтому его дисперсия ненулевая. Чтобы найти постоянный столбец в этом примере, не нужно вычислять дисперсию вручную: достаточно сравнить значения.
В документации scikit-learn по отбору признаков признаки с нулевой дисперсией описаны как признаки с одинаковым значением у всех объектов набора. Это свойство проверенных данных, а не обещание, что столбец останется постоянным при получении новых строк.
Как работает VarianceThreshold
VarianceThreshold — инструмент библиотеки scikit-learn для отбора признаков по дисперсии. В версии scikit-learn 1.9.1 при стандартном пороге threshold=0 он удаляет признаки с нулевой дисперсией и сохраняет признаки с ненулевой.
Последовательность для учебного набора такая:
- Выделить обучающий набор — данные, на которых определяется отбор признаков.
- Определить по нему дисперсию каждого признака.
- Исключить постоянные признаки. В нашей таблице это A; B останется.
Метод смотрит на признаки, но не учитывает целевые значения — то, что модель должна предсказывать. Поэтому сам по себе VarianceThreshold не оценивает связь признака с целью. Подробнее об условиях работы инструмента — в документации VarianceThreshold.
Когда одной проверки недостаточно
Новые данные. Признак может быть постоянным в обучающем наборе, но изменяться в будущих данных. Поэтому результат проверки относится к тому набору, на котором она проведена.
Положительный порог. Порог дисперсии можно изменить. При положительном пороге метод может удалить и непостоянные признаки. Их удаление требует отдельного обоснования: одного факта, что значения меняются мало по выбранному критерию, недостаточно для вывода об их связи с целью.
Пропуски. NaN — обозначение пропущенного значения. VarianceThreshold допускает NaN во входных данных, но наличие пропусков требует отдельного рассмотрения при проверке постоянства столбца. Таблица из примера их не содержит.
Нет подходящих признаков. Если ни один признак не удовлетворяет порогу дисперсии, VarianceThreshold выдаёт ошибку ValueError, а не результат с отобранными признаками. Эти условия приведены в описании инструмента.
Что попробовать самостоятельно
Составьте небольшую таблицу без пропусков: добавьте один столбец с одинаковыми значениями и один — с различающимися. Сравните значения внутри каждого столбца, найдите постоянный и уберите его. Затем проверьте, какой столбец остался.
Сформулируйте результат одной фразой: «В выбранной таблице этот признак не различает строки, потому что все его значения одинаковы». Уточнение о выбранной таблице важно: оно не распространяет вывод на будущие данные.
Не удаляйте изменяющиеся признаки только на основании этого упражнения. Для их удаления нужно отдельное обоснование; проверка дисперсии сама по себе не показывает связь признака с целью.