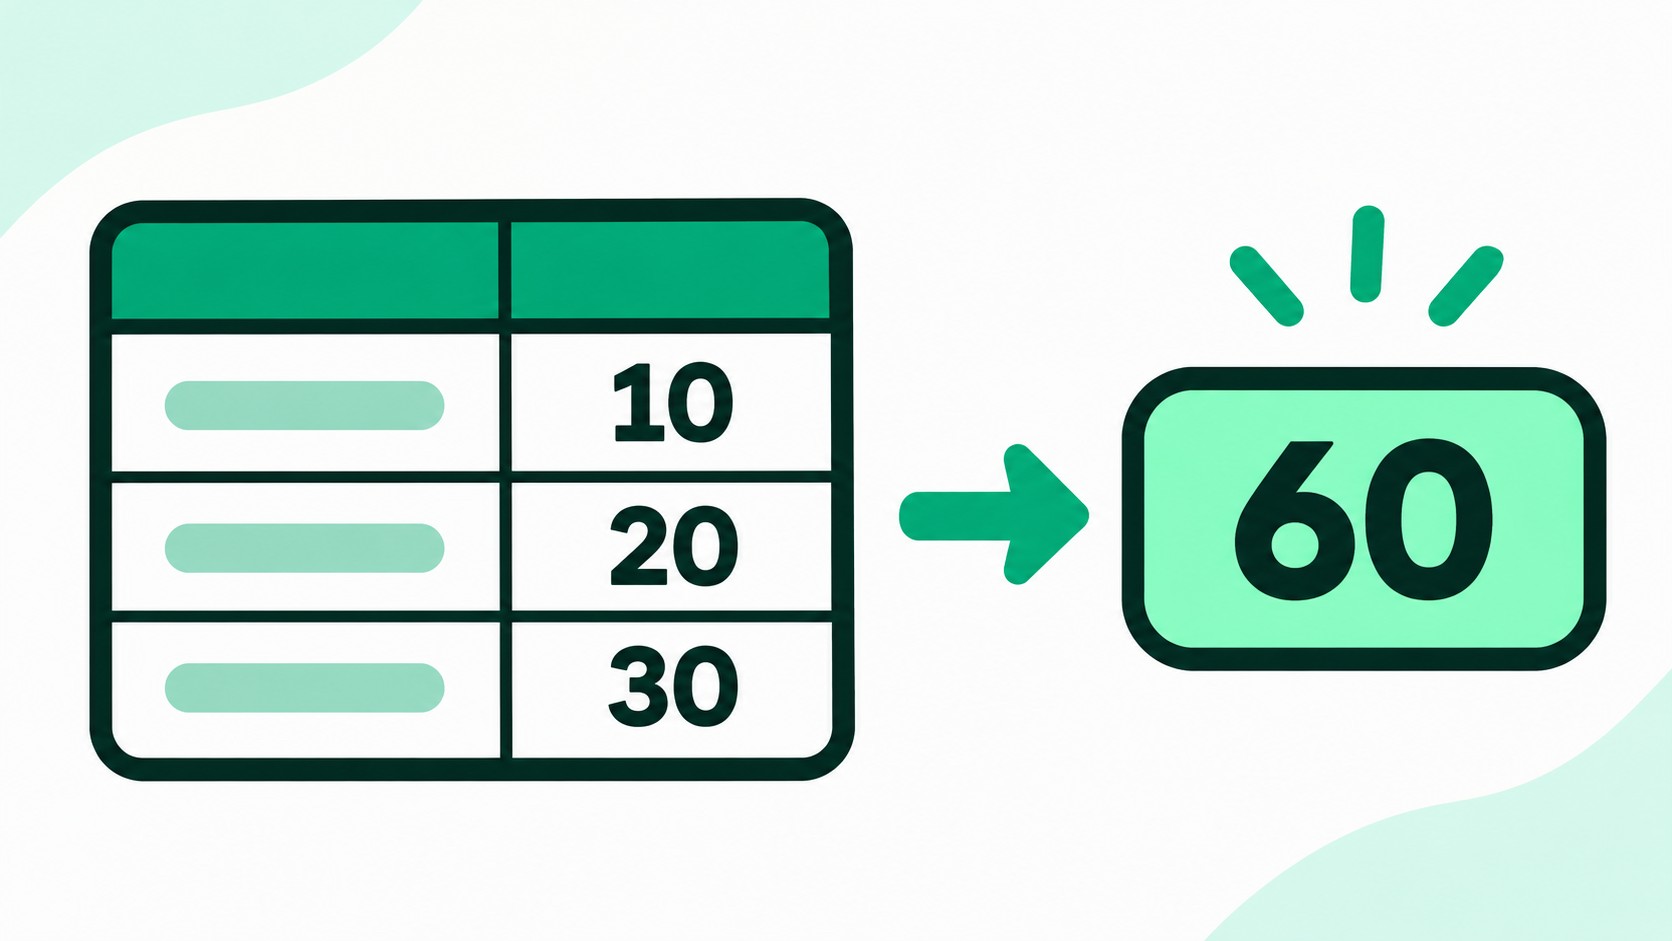
Один показатель получают из нескольких строк по выбранному правилу: строки можно посчитать, числовые значения — сложить или выбрать наибольшее из них. Получение одного результата из набора строк называют агрегированием.
Правило зависит от вопроса. Чтобы узнать, сколько записей в наборе, считают строки. Чтобы получить общий итог, складывают значения. Чтобы найти самое большое отдельное значение, выбирают максимум. Разберём эти варианты на условной таблице, не составляя SQL-запрос.
Что происходит со строками при агрегировании
Агрегатная функция — это правило, которое вычисляет один результат по входным строкам. Его назначение описано в документации PostgreSQL 18.
Результат относится к выбранному набору: если рассмотреть только часть таблицы, показатель будет описывать эту часть. Поэтому сначала определите, какие строки нужны, а затем выберите правило расчёта.
Дальше мы рассмотрим логику показателей в PostgreSQL 18 без написания запроса.
Количество, сумма и максимум на одной таблице
Возьмём условную таблицу заказов. В ней одна строка соответствует одному заказу, а сумма указана в условных денежных единицах.
| Заказ | Сумма |
|---|---|
| А | 200 |
| Б | 300 |
| В | 500 |
К этим строкам можно задать разные вопросы:
| Вопрос | Правило | Результат |
|---|---|---|
| Сколько заказов записано? | Посчитать строки | 3 заказа |
| Какова общая сумма заказов? | Сложить значения | 200 + 300 + 500 = 1000 условных единиц |
| Какова наибольшая сумма одного заказа? | Выбрать наибольшее значение | 500 условных единиц |
Результаты получены из одного набора, но отвечают на разные вопросы. Сумма 1000 показывает общий размер заказов, а не их количество. Количество можно узнать, посчитав строки: по условию каждая соответствует одному заказу.
В PostgreSQL 18 для таких расчётов используют агрегатные функции: count(*) считает входные строки, sum складывает значения, а max находит наибольшее значение. Подробности и ограничения описаны в документации по агрегатным функциям.
Как выбрать показатель для своего вопроса
Перед расчётом пройдите по короткому списку:
- Определите набор: какие строки вы хотите рассмотреть?
- Уточните смысл строки: например, соответствует ли каждая строка одному заказу?
- Сформулируйте вопрос: нужно количество строк, общий итог по числовому столбцу или наибольшее отдельное значение?
- Проверьте единицы результата. В примере количество выражается числом заказов, а сумма и максимум — в условных денежных единицах.
Попробуйте сами: какой показатель выбрать для вопроса «Какова сумма самого крупного заказа?»
Ответ — максимум. Он покажет наибольшую сумму отдельного заказа. Сумма всех значений ответила бы на другой вопрос: каков общий итог заказов в выбранном наборе.
Что меняется при пропусках и пустом наборе
Представим, что сумма заказа В неизвестна. Обозначим отсутствие значения как NULL:
| Заказ | Сумма |
|---|---|
| А | 200 |
| Б | 300 |
| В | NULL |
Строк по-прежнему 3, но известных значений суммы только 2. Это различие важно: count(*) считает все входные строки, а count для значения столбца — только строки, где это значение не равно NULL.
Функции sum и max исключают NULL из расчёта. Поэтому сумма известных значений равна 200 + 300 = 500 условных единиц, а максимум среди них — 300 условных единиц. Неизвестная сумма заказа В не учтена: эти результаты не описывают общий итог и максимум с учётом её значения. Правила относятся к PostgreSQL 18 и приведены в документации по агрегатным функциям.
Отдельный случай — когда в набор не попала ни одна строка. В PostgreSQL 18 количество строк будет равно 0, а сумма и максимум вернут NULL, а не ноль. Поэтому отсутствие выбранных строк не стоит автоматически трактовать как нулевую сумму.
Чтобы закрепить разницу, возьмите небольшую таблицу и определите, что означает её строка. Затем задайте три вопроса: сколько строк, какова сумма значений и какое значение наибольшее. Выберите правило для каждого вопроса и проверьте результат вручную.