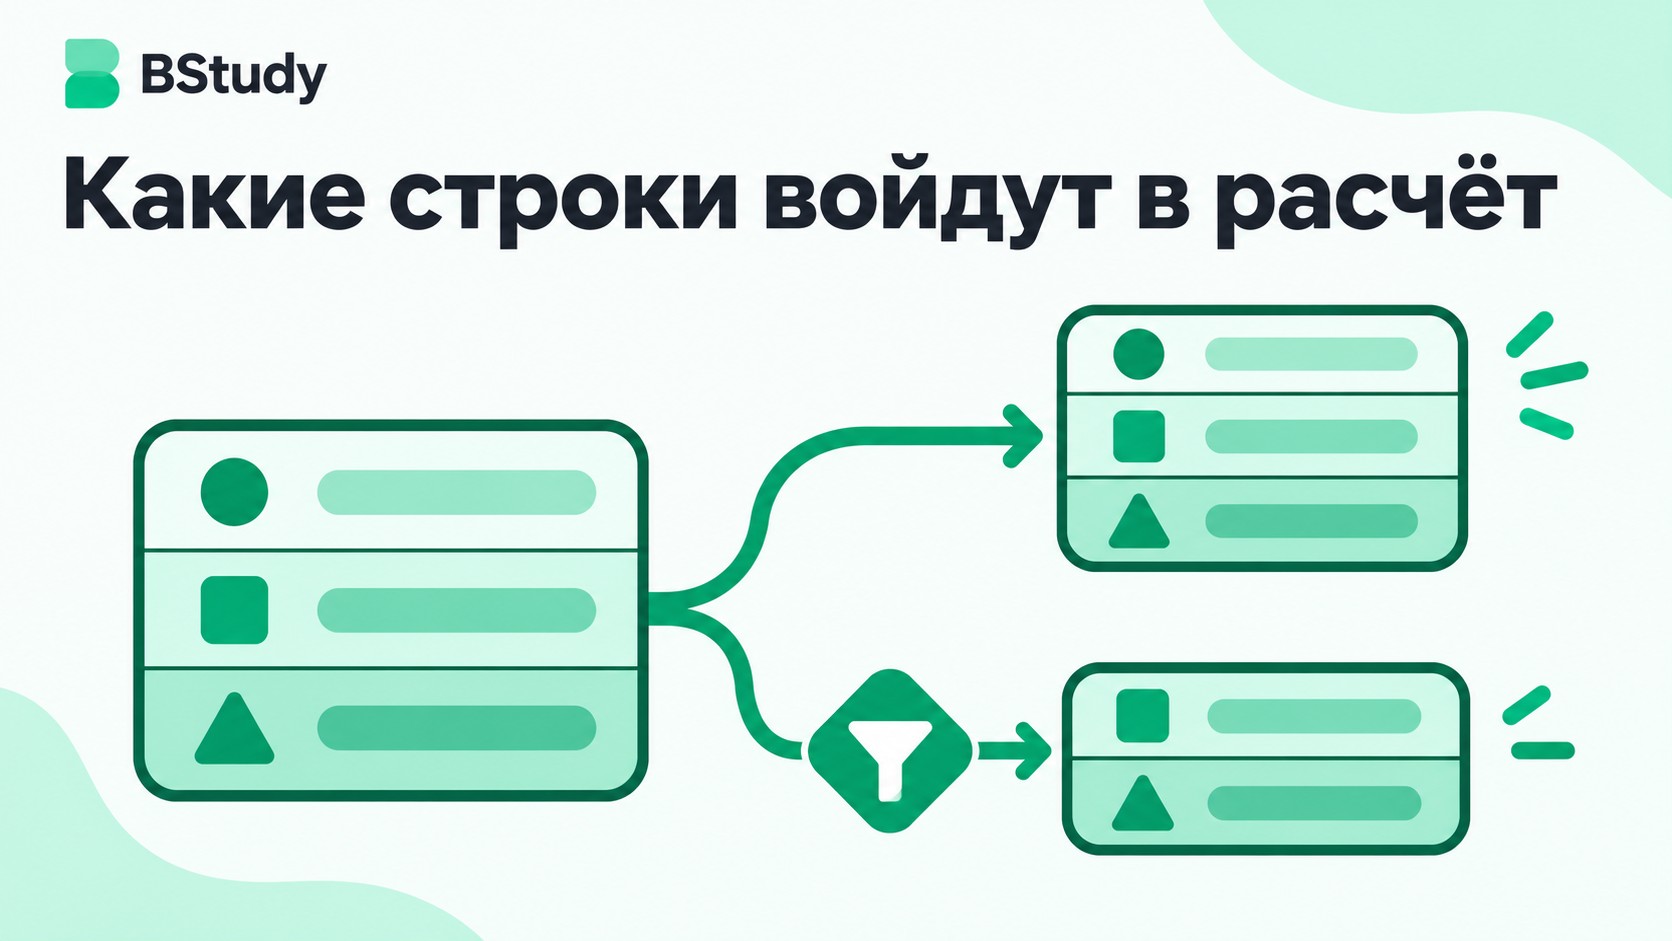
Показатель по всем строкам таблицы и показатель по заранее отобранным строкам отвечают на разные вопросы. Даже при расчёте одного и того же среднего результаты могут различаться: в них входят разные данные.
В PostgreSQL 18 логический порядок такой: условие WHERE определяет входные строки, а затем агрегатная функция вычисляет по ним результат. Чтобы проверить показатель, сначала перечислите строки, которые войдут в расчёт, и только потом считайте.
Из каких строк складывается показатель
Агрегатная функция вычисляет один результат по нескольким входным строкам. Например, с её помощью можно получить среднее значение. Определение приведено в документации PostgreSQL 18.
Прежде чем интерпретировать среднее, уточните вопрос:
- Каково среднее по всем строкам таблицы?
- Каково среднее только по строкам, которые отвечают заданному условию?
Название показателя в обоих случаях одинаковое — среднее. Но набор входных строк может быть разным, поэтому важно указывать, какие данные описывает результат.
Что происходит при предварительном отборе
Условие WHERE содержит логическое выражение — проверку, результат которой определяет, проходит ли строка отбор. Проходят только строки, для которых выражение истинно. Если результат ложный или неизвестен, строка не проходит. Это правило описано в разделе документации PostgreSQL 18 о запросах к таблице.
Для расчёта без группировки последовательность можно представить так:
- Определить условие отбора.
- Оставить строки, для которых условие истинно.
- Вычислить агрегатный показатель по оставшимся строкам.
Если предварительного отбора нет, в нашем примере в расчёт войдут все строки таблицы. Если отбор есть, показатель будет относиться только к прошедшему условие подмножеству.
Это описание логического порядка обработки в PostgreSQL 18. Оно помогает понять результат запроса, но не утверждает, что действия физически выполняются именно в таком порядке. Различие предварительного отбора и агрегирования объясняется в документации PostgreSQL 18.
Пример: среднее по всем строкам и по части таблицы
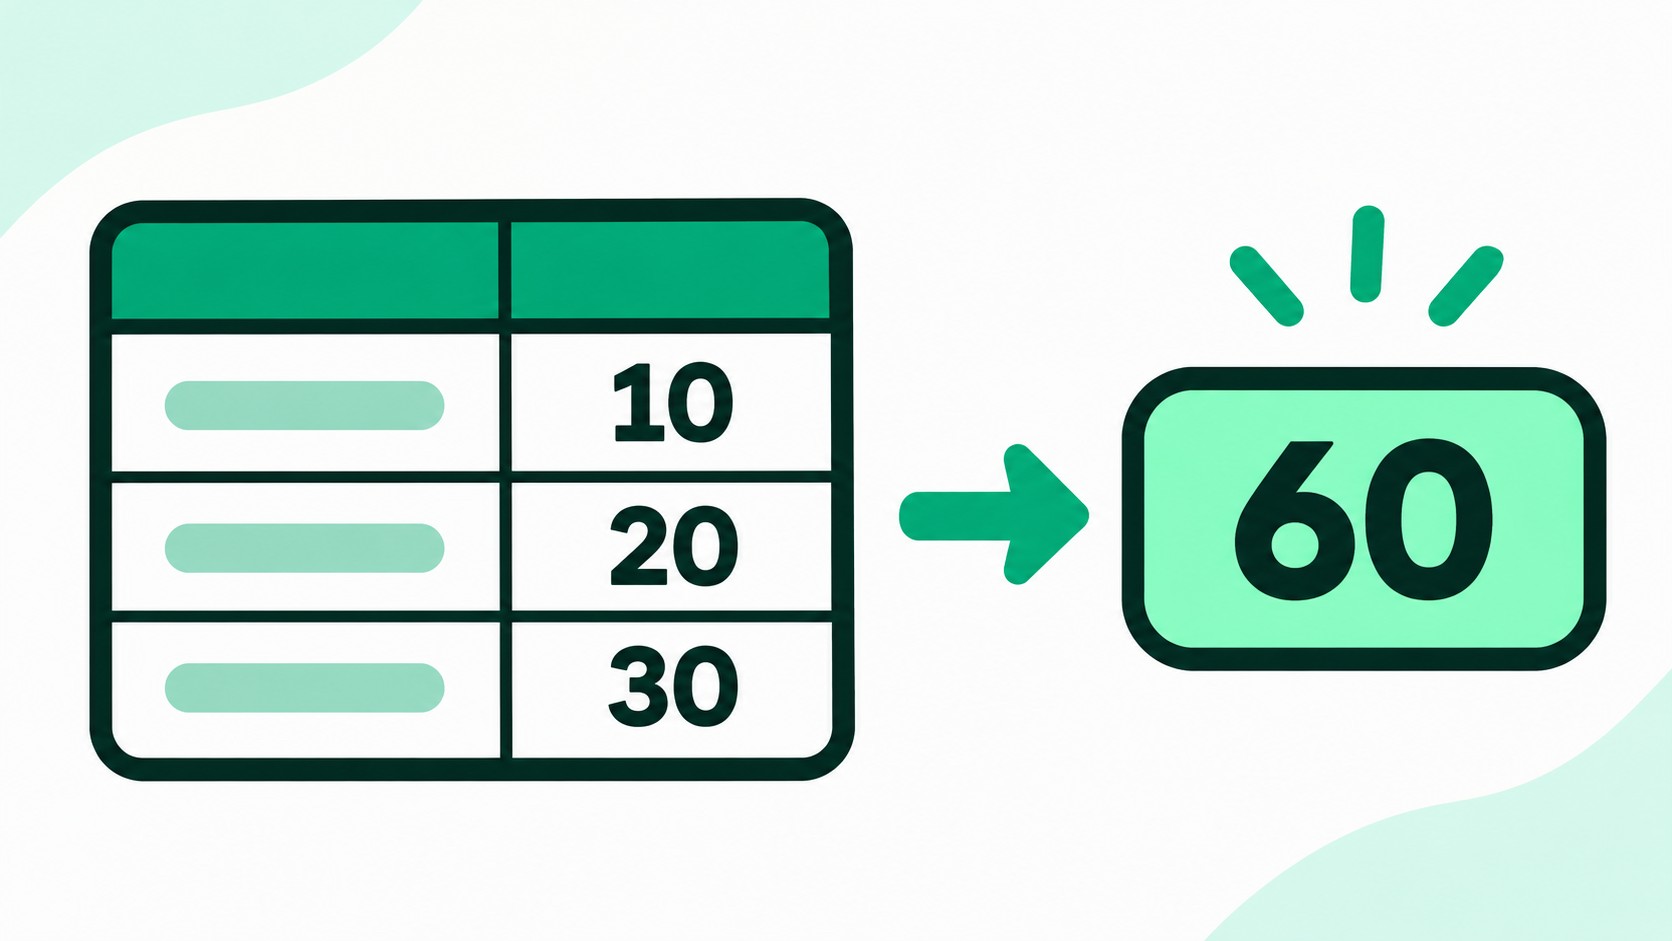
Возьмём условную учебную таблицу:
| Значение | Выбрана |
|---|---|
| 10 | нет |
| 20 | да |
| 30 | да |
Среднее по всей таблице
Вопрос: каково среднее значение по всем строкам таблицы?
В расчёт входят значения 10, 20 и 30:
(10 + 20 + 30) / 3 = 20
Среднее по всей таблице — 20.
Среднее по выбранным строкам
Теперь зададим условие «выбрана = да». Ему отвечают строки со значениями 20 и 30. Строка со значением 10 в расчёт не входит.
Вопрос изменился: каково среднее значение только среди выбранных строк?
(20 + 30) / 2 = 25
Среднее по выбранным строкам — 25. В этом примере оно отличается от среднего по всей таблице, потому что входные наборы разные. При разных наборах результаты не обязательно будут различаться, поэтому важно проверять, какие строки описывает каждый показатель.
Границы сравнения и следующий шаг
В примере мы сравнили один показатель без группировки. Группировка объединяет строки в группы для расчёта показателей по ним. При работе с группами важно не путать предварительный отбор WHERE с условием HAVING: WHERE отбирает входные строки до вычисления групп и агрегатов, а HAVING отбирает строки групп после их вычисления. HAVING не следует представлять как предварительное удаление отдельных входных строк из агрегата. См. объяснение в документации PostgreSQL 18.
Этот разбор не заменяет справочник по синтаксису SQL: его цель — помочь определить, что именно описывает результат.
Попробуйте изменить условие в учебной таблице: вместо «выбрана = да» возьмите «выбрана = нет». Сначала выпишите подходящие значения, затем вручную найдите их среднее и сформулируйте вопрос, на который оно отвечает. Сверьте каждый шаг с исходной таблицей: входит ли в расчёт хотя бы одна строка, которая не отвечает новому условию?