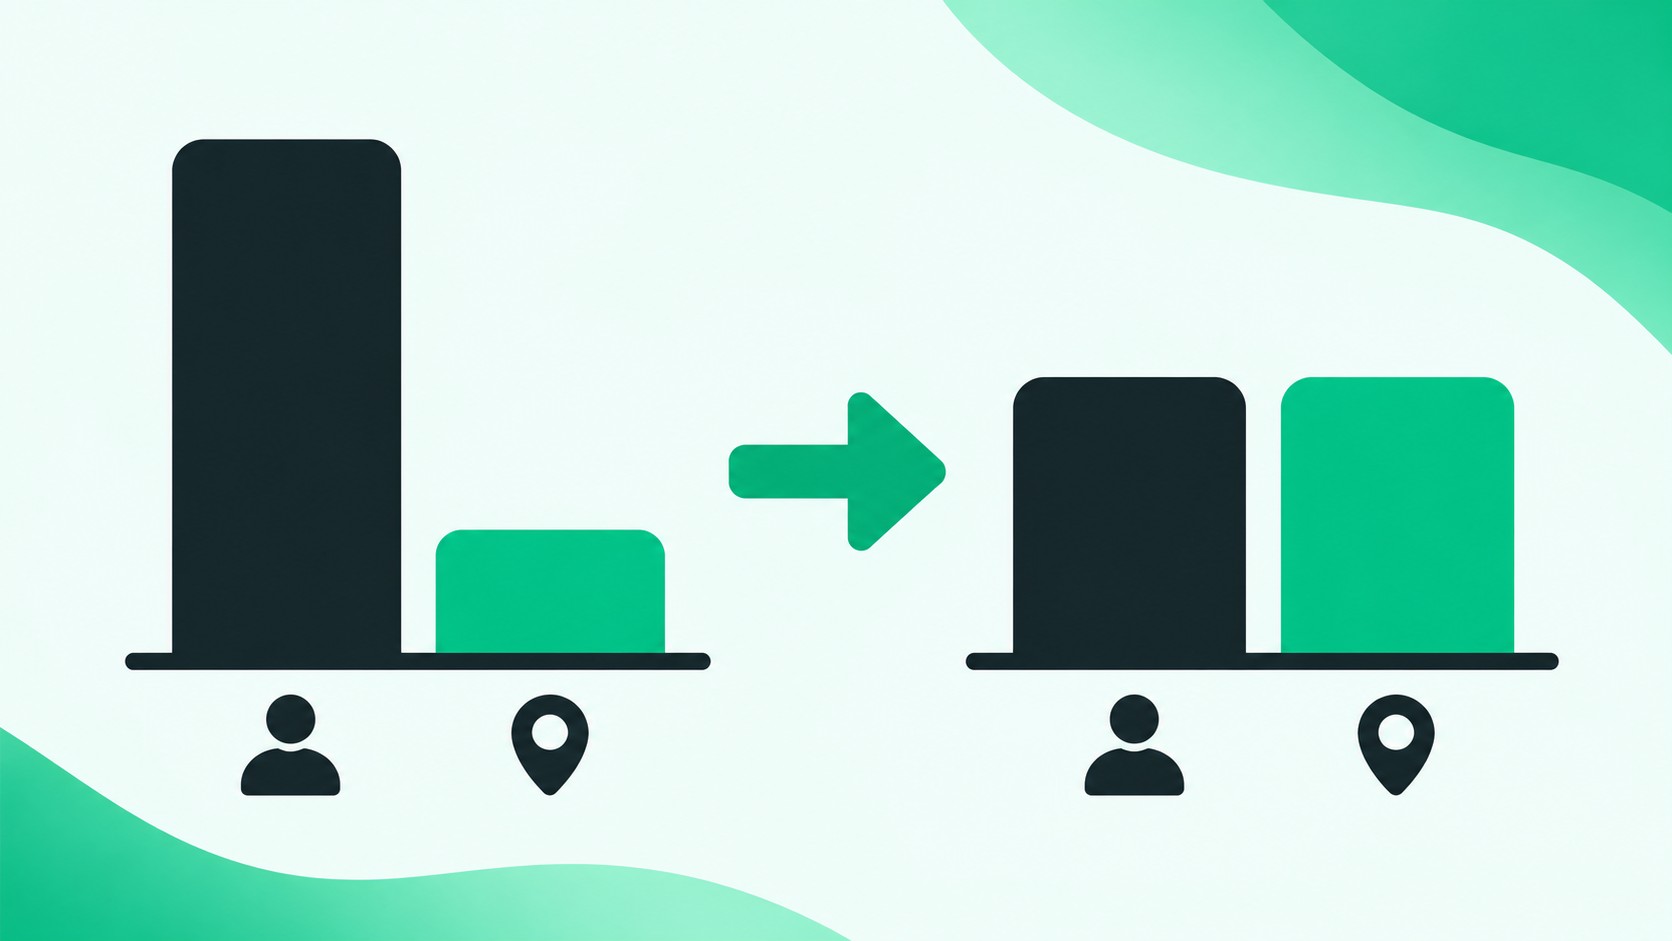
Масштаб признаков стоит проверить, если модель использует расстояния между объектами. Признак с большим числовым диапазоном может сильнее влиять на расчёт, хотя для задачи это не обязательно оправданно. Стандартизация помогает привести признаки к сопоставимому масштабу, но нужна не каждой модели и сама по себе не исправляет выбросы.
Когда разница в масштабе влияет на модель
Признак — это характеристика объекта, представленная в таблице столбцом: например, возраст в годах или расстояние до объекта в метрах. Разные единицы измерения могут давать очень разные числовые диапазоны.
Метод ближайших соседей сравнивает объекты по расстоянию между ними. В таком расчёте различия признака с большим диапазоном могут преобладать. Именно это произошло в примере из документации scikit-learn. Насколько сильно проявится эффект, зависит от данных и способа расчёта расстояния.
Для моделей на основе деревьев решений масштабирование обычно почти не меняет результат. Это не означает, что результат будет одинаковым для любой реализации и любых данных: проверять преобразование стоит с учётом конкретной задачи.
Как работает стандартизация
Стандартизация преобразует значения каждого признака отдельно. Для непостоянного признака из каждого значения вычитают среднее этого столбца, а результат делят на стандартное отклонение — меру разброса значений:
стандартизированное значение = (значение − среднее) / стандартное отклонение
Если все значения признака одинаковы, его стандартное отклонение равно нулю и деление по этой формуле неприменимо. Стандартизация сама по себе не делает распределение значений нормальным. Принцип преобразования описан в документации scikit-learn.
Пример: возраст и расстояние до объекта
Возьмём условную обучающую таблицу с двумя объектами:
| Объект | Возраст, лет | Расстояние, метров |
|---|---|---|
| А | 20 | 1000 |
| Б | 40 | 3000 |
Сравним объекты с помощью евклидова расстояния: возведём разницу по каждому признаку в квадрат, сложим результаты и извлечём квадратный корень. До стандартизации расчёт выглядит так:
- разница по возрасту: 40 − 20 = 20; её квадрат — 400;
- разница по расстоянию: 3000 − 1000 = 2000; её квадрат — 4 000 000;
- евклидово расстояние: √(400 + 4 000 000).
В этом примере численный вклад расстояния в метрах в сумму квадратов намного больше. Это следствие выбранных данных, единиц измерения и способа расчёта, а не доказательство того, что этот признак важнее для задачи.
Теперь вычислим параметры по обучающей таблице. Средний возраст — 30 лет, стандартное отклонение — 10 лет. Среднее расстояние — 2000 метров, стандартное отклонение — 1000 метров. Здесь стандартное отклонение рассчитано по всей условной обучающей таблице.
| Объект | Стандартизированный возраст | Стандартизированное расстояние |
|---|---|---|
| А | (20 − 30) / 10 = −1 | (1000 − 2000) / 1000 = −1 |
| Б | (40 − 30) / 10 = 1 | (3000 − 2000) / 1000 = 1 |
После стандартизации разница по каждому признаку равна 2. Вклад каждого в сумму квадратов теперь равен 4, а расстояние между объектами — √(4 + 4). Масштаб вкладов изменился, но этот расчёт не доказывает, что качество модели улучшится.
Почему выбросы нужно изучить отдельно
Выброс — необычно далёкое значение признака. Например, если в столбце расстояний встретилось значение, сильно отличающееся от остальных, стоит выяснить его природу. Оно может оказаться ошибкой, но автоматически считать его ошибочным и удалять не следует.
StandardScaler — средство стандартизации в scikit-learn — чувствителен к выбросам: они могут влиять на результат масштабирования. Это ограничение отмечено в описании StandardScaler.
При наличии выбросов устойчивые к ним методы масштабирования или другие преобразования могут подойти лучше. Выбор зависит от данных и задачи; преимущество такого преобразования не гарантировано. Подробнее о вариантах рассказывает документация по предварительной обработке.
Как применить преобразование без смешения выборок
Обучающая выборка — данные, на которых обучают модель. Тестовая выборка — отложенные данные для её проверки. Для стандартизации важно сохранить это разделение:
- Разделите данные на обучающую и тестовую выборки.
- Вычислите среднее и стандартное отклонение каждого признака только по обучающей выборке.
- Примените полученные параметры к обучающей выборке.
- Примените те же сохранённые параметры к тестовой выборке, не вычисляя для неё отдельные средние и стандартные отклонения.
Так, в условном примере для преобразования возраста в тестовых данных использовались бы среднее 30 лет и стандартное отклонение 10 лет, полученные из обучающей таблицы. StandardScaler сохраняет вычисленные на обучающих данных статистики для последующего преобразования; это описано в документации.
Следующий шаг — посмотреть на собственную таблицу: какие числовые признаки измерены в разных единицах, насколько различаются их диапазоны и есть ли необычные значения? Сопоставьте наблюдения с выбранным алгоритмом, прежде чем решать, нужна ли стандартизация.